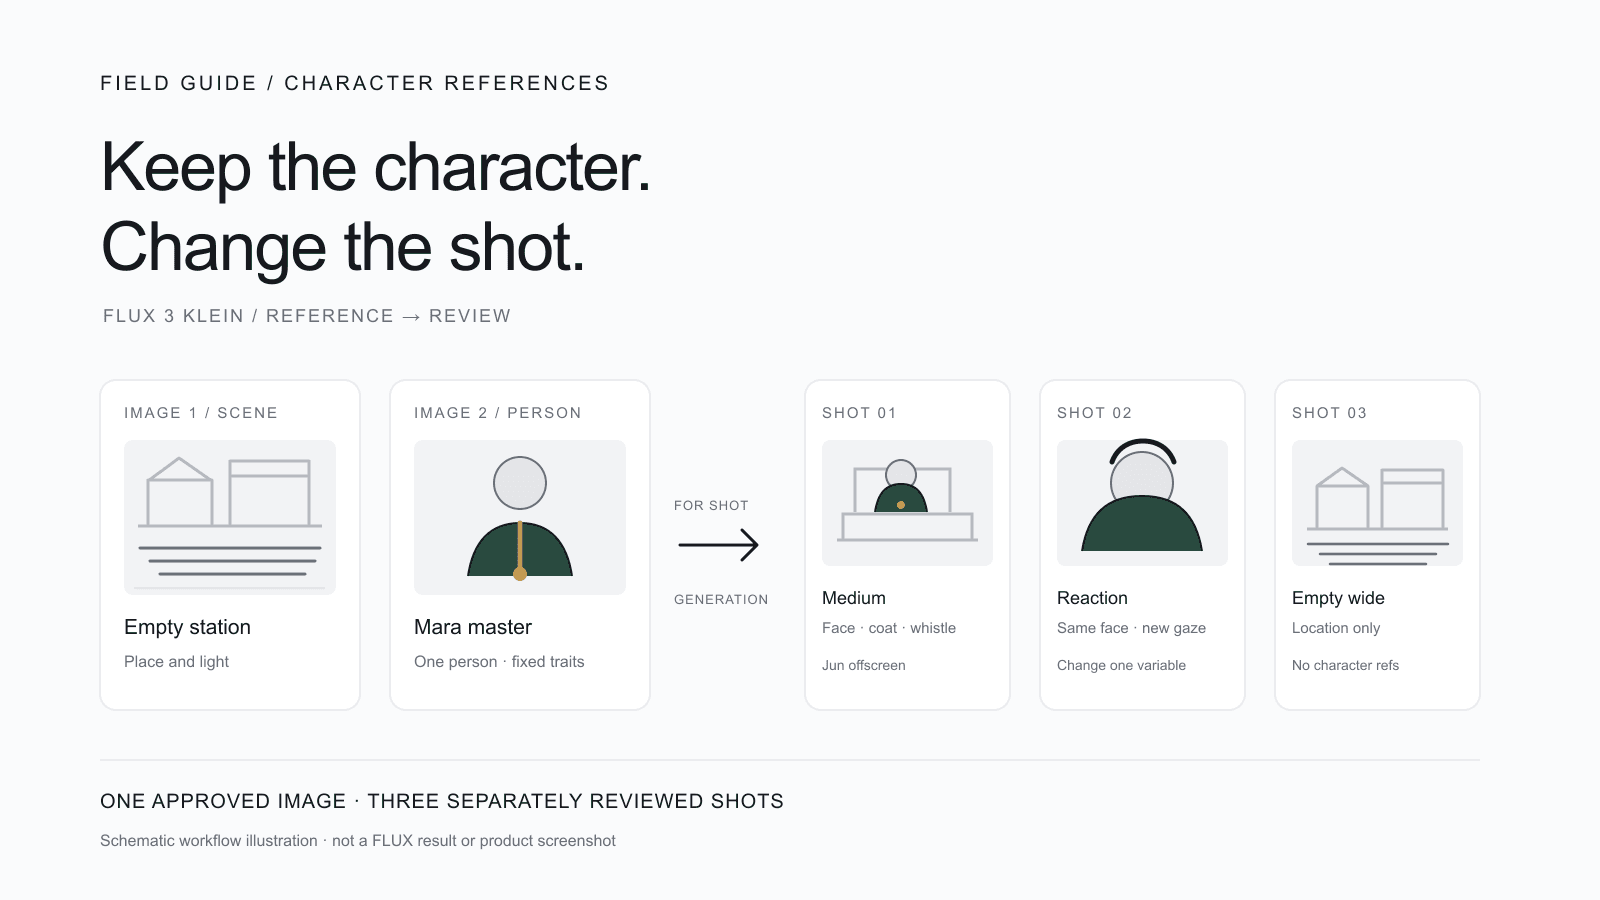
制作指南
FLUX 3 Klein 角色参考图怎么准备:三镜头一致性检查
用 FLUX 3 Image Klein 整理单张角色主参考、分配参考图职责,并逐镜审核三张画面;参考图能锚定内容,但不保证每次生成完全相同。
 Pencil0
用 Fish Audio Drama 3 做双人对白:分配两个声音、复制四句场景、排查角色说反和模型选择问题,再按试听结果安排短片剪辑。

Pencil0
作者
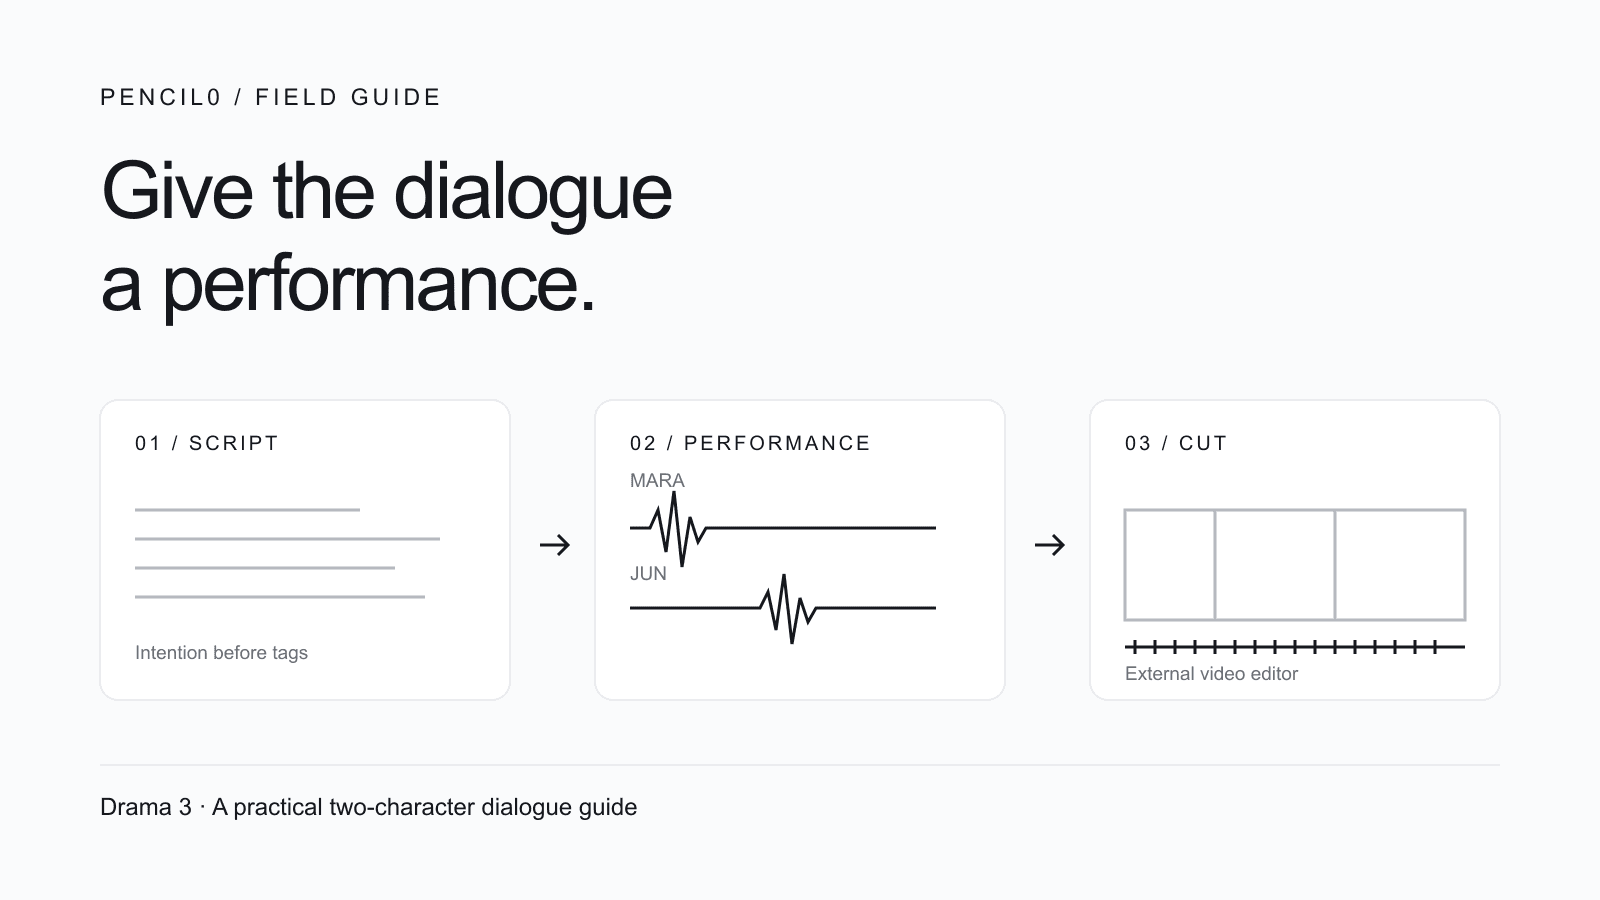
用两种声音生成对白,先给每个角色分配一个声音,后续修改保持对应关系不变。先做一小段交流,确认每句由谁说,再调整情绪。
双人戏的难点不只是找两种不同的声音。一个人在掩饰恐惧,另一个人本来只想结束工作,却突然听见一句不可能的话。配音要让观众听出这次变化,剧本就需要写清楚每个人想做什么。
这篇指南提供一段原创场景、角色声音表、可复制的表演稿、网页和 API 两种用法,以及试听检查和配画面的流程。你可以先完成一小场戏,再决定是否扩大到整集。
Pencil0 当前没有集成 Fish Audio Drama 3。 Drama 3 的语音需在 Fish Audio 侧生成;Pencil0 可以帮助规划剧本、角色参考和镜头,但本文不代表站内已有 Drama 3 按钮或外部配音导入功能。下列内容是基于官方文档编写的原创操作示例,我们尚未生成、试听这些脚本的音频,不把它们称为实测效果。
Drama 3 是 Fish Audio 的文本转语音模型,不是视频模型。官方更新日志将它的公告日期列为 2026 年 10 月 13 日。产品页目前标注 Preview,生成的不同 take 可能有差异,因此第一版适合当作试音。
本文要完成的交付物是:一段选定的对白音频,加一份角色与声音的对应记录。它不会自动变成口型同步的短片,也不等于每位演员的独立音轨或精确到毫秒的声音时间表。
用原创场景《末班车》开始:车站值班员遇到一名旅客,他拿着一张通往早已关闭站台的车票。
| 角色 | 选声音时的目标 | 此刻想达成的事 | 场景内的变化 |
|---|---|---|---|
| 玛拉,值班员 | 清楚、平稳、日常交流感 | 让旅客离开站台 | 从例行提醒变成担忧 |
| 小俊,旅客 | 较轻、克制,与玛拉容易区分 | 确认等待自己的人还在不在 | 从回避变成直接追问 |
“声音是什么样”用于选演员;“角色此刻要做什么”用于写表演指令。小俊最后一句需要更有力度,并不意味着要换一个声音。
先保留一份没有标签的对白:
玛拉:末班车十分钟前就开走了。
小俊:那为什么,还有人在喊我的名字?
玛拉:哪个站台?
小俊:你上车的那个。二十年前。
场景环境和镜头要求另写进分镜表。“空车站全景”不是要念出来的台词,不要混进语音生成正文。
Drama 3 专属指南说明了方括号指令、声音与停顿,以及只影响部分词语的成对标签。下面是一版克制的起点。角色名仅用于阅读,不是 API 的说话人标识。
玛拉:[例行提醒,准备结束一天的工作] 末班车十分钟前就开走了。
小俊:[压着恐惧,不想让对方察觉] 那为什么,还有人在喊我的名字?
玛拉:[收起不耐烦,开始认真担心] 哪个站台?
小俊:[平静,想让她回忆起来] <emphasis>你</emphasis>上车的那个。[pause] <whisper>二十年前。</whisper>
每个标注都应有目的:玛拉在听完问题后才改变语气;重读“你”改变了指向;停顿把最后的揭示留到后面。“恐怖、电影感、戏剧化、情绪饱满”堆在一起,反而难以判断究竟该改哪里。
修改时可以写一条三段式导演笔记:保留什么 → 改什么 → 改哪一处。例如:“保留小俊的克制;让指认更清楚;只调整‘你’这个字。”这是本文的编辑方法,不是模型的特殊命令。
不要一开始就给同一句叠加哭喊、耳语和愤怒。先确认角色和台词正确,再每次只调整一个意图或一个短语。[pause] 是表演提示,不保证精确的停顿时长。
需要你自己的 Fish Audio 账号;可用入口和额度以账号当前显示为准。
以上流程依据官方公开的编辑器说明整理,本文没有登录验证你账号的界面。若当前账号没有 Drama 3 入口,先核实官方开放情况,不要换成别的模型后仍把结果称为 Drama 3。
TTS API 参考使用 reference_id 数组分配声音:第一个对应 <|speaker:0|>,第二个对应 <|speaker:1|>。后续修改保持顺序不变。
| 角色 | reference_id 中的位置 | 每轮台词开头 |
|---|---|---|
| 玛拉 | 第一个声音 ID | <|speaker:0|> |
| 小俊 | 第二个声音 ID | <|speaker:1|> |
将下面内容保存成 scene.json,把两个占位符换成自己账号中可用的声音 ID:玛拉在前,小俊在后。占位符本身不能用于生成。
{
  "text": "<|speaker:0|>[例行提醒,准备结束一天的工作] 末班车十分钟前就开走了。\n<|speaker:1|>[压着恐惧,不想让对方察觉] 那为什么,还有人在喊我的名字?\n<|speaker:0|>[收起不耐烦,开始认真担心] 哪个站台?\n<|speaker:1|>[平静,想让她回忆起来] <emphasis>你</emphasis>上车的那个。[pause] <whisper>二十年前。</whisper>",
  "reference_id": ["REPLACE_WITH_MARA_VOICE_ID", "REPLACE_WITH_JUN_VOICE_ID"],
  "format": "mp3"
}
在本机环境变量 FISH_API_KEY 中设置好自己的 API key 后执行:
: "${FISH_API_KEY:?Set FISH_API_KEY locally before running}"
curl --fail --show-error --silent \
  https://api.fish.audio/v1/tts \
  --header "Authorization: Bearer ${FISH_API_KEY}" \
  --header "Content-Type: application/json" \
  --header "model: drama-3" \
  --data-binary @scene.json \
  --output scene.mp3
这会消耗 Fish Audio 侧的 API 额度,不使用 Pencil0 积分。本文仅按文档核对了请求,尚未实际发送。API 文档说明,model 请求头缺失或值无法识别时会回退至 s2.1-pro;仅凭请求成功不能证明你选择了 Drama 3。收到 401 先检查鉴权;收到 402 先检查账号余额或额度,再考虑重试。
把无标签剧本放在音频旁边。先不看文字听一遍,再逐字对照听一遍:第一遍判断戏是否成立,第二遍检查是否漏字。流畅的表演也可能掩盖内容缺失。
| 检查项 | 接受这个 take 前要回答的问题 | 没通过时先做什么 |
|---|---|---|
| 角色 | 每一轮都能分清玛拉和小俊吗? | 先查说话人分配与 ID 顺序,不急着改情绪 |
| 台词 | 四句是否完整,最后的揭示有没有丢? | 缩短有问题的一轮,移除非口播舞台说明 |
| 意图 | 玛拉是否在听完问题后才开始担忧? | 用变化原因替代泛泛的情绪词 |
| 揭示 | “你”的重音是否清楚,又没有提前泄露结尾? | 保留整句,只改重音或停顿 |
| 连续性 | 与相邻场景是否仍像同一批演员? | 对照保存的声音 ID 和已接受的参考 take |
| 剪辑 | 反应和结尾是否留出了空间? | 给画面多留余量,或删减对白,再考虑加快语速 |
这些是建议的验收问题,不是已经生成的测试结果。文件可命名为 last-train-zh-take-02.mp3,同时记录剧本版本、声音 ID、模型和这一次修改了什么。保留最终音频及精确输入,不能假设重复输入就能得到完全一样的声音。
中文多音字先参考 中文音素控制文档:用带声调数字的拼音,每个音节一对音素标签。英文专名则参考 英文文档,其格式是 CMU Arpabet,不是 IPA。只处理有歧义的那个词,再放回完整句子试听。
例如下面是本文自拟的中文输入写法,用于指定“行”的读音,不代表已验证音频:
这张票,在那家银<|phoneme_start|>hang2<|phoneme_end|>旁边找到的。“用中文写表演指令”和“强制切换口播语言”是两件事。Drama 3 的语言切换标签仍标为实验性;双语影片应分别检查两种语言的表演,不要期待翻译后时长、停顿与情绪自动一致。
不要还没听音频,就把一句话锁进四秒特写。先在剪辑器中标出每句台词实际的起止时间,再围绕台词和反应安排画面。
| 情节点 | 建议画面 | 剪辑时保留什么 |
|---|---|---|
| 玛拉的第一句 | 售票窗口后的中景 | 用例行提醒建立日常感 |
| 小俊的问题 | 旅客近景 | 不要把犹疑的空隙全部剪掉 |
| “哪个站台?” | 玛拉反应特写 | 让人物意图的变化可见 |
| 小俊揭示结尾 | 小俊,再转空站台 | 留一点时间让最后几个字产生作用 |
这是编辑建议,不是模型输出的自动时间表。把选定的对白放到独立视频剪辑器的画面下,决定它是替换生成视频的对白,还是仅作为表演参考;同一句话叠放两版声音,容易出现双重对白。口型需要单独检查,好听的配音不会自动让画面中的嘴型同步。
用 AI 短剧工作流把创意发展成分集剧本,用 AI 分镜工作流安排每个情节点的构图和动作;审核镜头时,可把声音角色表与 角色一致性工作流放在一起检查。
Pencil0 当前的角色声音链路使用 Gemini TTS 生成短参考音频,支持音频参考的视频请求可以复用它。它与完成整场对白的 Drama 3 音轨用途不同,也不保证每个 take 的声音完全一致。Pencil0 当前没有集成 Drama 3,本文也没有确认将外部 Drama 3 音频导入 Pencil0 的可用路径。 需要采用该音轨时,请在外部剪辑器中完成合成。Pencil0 目前为邀请制,实际入口以相关产品页说明为准。
一起检查声音 ID 的顺序和该轮台词开头的说话人标签。如果 reference_id 的第一个 ID 是小俊,<|speaker:0|> 就会选中小俊,即使笔记里把这个位置叫作玛拉。先修正对应关系,再改表演指令。“玛拉:”之类阅读标签不要当作要念出的正文。
检查是否发送了完全一致的 HTTP 请求头 model: drama-3。API 文档说明,漏写或使用无法识别的值会回退到 s2.1-pro;HTTP 成功不等于选对模型。再把实际提交文本与保存的脚本逐字核对,不要凭印象判断标签有没有传入。
把停顿提示当作表演要求,接受音频后在剪辑器测量实际台词和反应长度,再安排镜头。本文流程不提供逐帧精确停顿、每位角色独立音轨或自动口型同步,这些需要在剪辑环节单独检查。
本文用外部剪辑器处理最终对白轨。Pencil0 的 Gemini 短角色声音参考是另一类输入,本文没有确认 Drama 3 成品配音导入能力。同一场戏的画面准备可参考角色参考图教程,里面有固定身份记录和三镜头外观核对表。
来源核验日期:2026 年 10 月 15 日。 官方更新日志、Drama 3 产品与编辑器说明、Drama 3 语法指南、托管 TTS API、中文发音、英文发音及 声音参考录音建议。本文剧本、角色表、镜头安排和试听检查表均为原创教学示例,不是 Fish Audio 的演示素材或已生成效果。
**2026 年 10 月 16 日复核:**已对照官方 Drama 3 指南与 TTS API 参考,核对说话人映射和模型请求头回退行为。
把读到的方法用在创作中。在 Pencil0 里发展故事、准备角色参考和分镜,再一步步生成影片。
加入候补